X線と物質の相互作用とそれを利用した分析装置のまとめ

最近ではどこの研究機関でも結構良いX線解析装置を一つ、二つ持っているものだろう。 広角散乱では精度の高いRIGAKUかBrukerの結構高級な装置をどこの機関にいっても見かけるし、結構立派なXPSや小角散乱装置などを自前で揃えている研究機関も多くなって来ている。
最近のX線関係の装置は使いやすく調整されているので、ちょっとしたトレーニングを受ければすぐに使えるようになる。 安全装置もしっかりついているので、かなりがんばらないとX線に晒されるなんていうこともないだろう。
解析手法も多岐にわたって確立されている。 自分がどのような情報が知りたいかを理解していれば、そのためのX線装置と解析法を探すのはそう難しくはない。 よっぽど特殊なサンプルを使う研究者や、新しい解析手法の開発をしてる装置屋さんなどになると話しは別だが。

X線を使う理由

なぜX線を使うかを一言にすると、見えないものが見るためだ。 光学顕微鏡での限界は約200ナノメートルといわれており、これ以下のサイズのものを見たかったら何かしら可視光以外のものを使う必要が出てくる。 X線はそんなツールの一つといえる。
他の電子顕微鏡などのツールに比べた良い点は、比較的前処理なしでサンプルそのままの構造を見ることができること。 またサンプルを割と非破壊で測定することができること。 浸透力もそれなりに強いので内部構造を見るのにも適している。 一方で装置や手法によっては表面構造観察に優れていること。 あとはX線装置次第でサンプル環境が割と自由に調整でき、温度・湿度やサンプルへの張力などの条件が変えやすいことなど。 挙げだすときりがなくメリットがある。

X線と物体の相互作用

X線の物質による散乱

X線と物体の相互作用

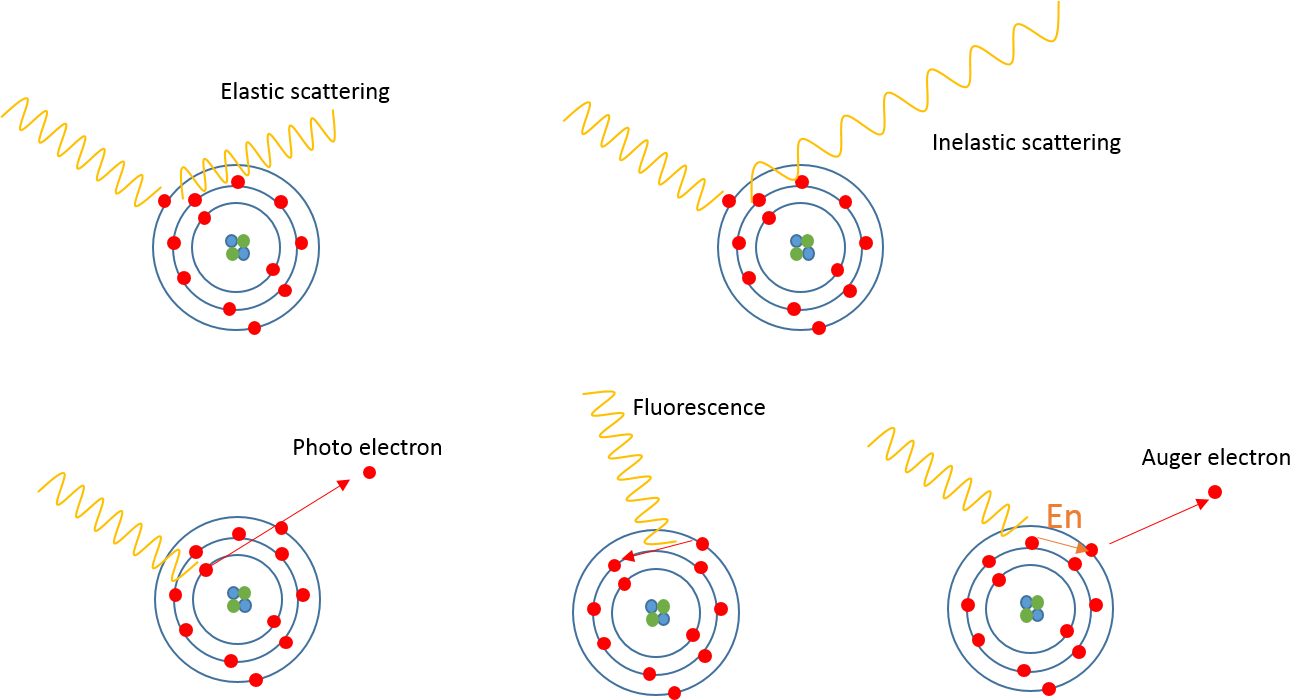
さてX線が物体(の電子)と出会った時いくつかの異なる相互作用が起こりうる。 大雑把に分けると電子によって散乱されるX線と、光電効果などで電子をふっとばす場合だ。 もっともよく使われるのが弾性散乱(トムソン散乱)であり、構造由来の回折やら散乱やらを発生させる。 弾性散乱ではX線の波長ひいてはエネルギーは散乱前後で同じである。
弾性散乱があるということは非弾性性散乱(コンプトン散乱)もある。 こちらの散乱も原子の動的挙動を見る?などの使い道はあり、特に中性子分野では良く使われている。 しかし私は全く詳しくないし、弾性散乱を利用したい際には単なるバックグラウンドでしかない。
ちょっとややっこしいのが干渉性散乱と非干渉性散乱という区分けもある。 こちらの区分では散乱前後のphase・位相が同じかどうかということが重要。 ちょっとまだ噛み砕けていないのけど、回折や小角散乱の場合は干渉性弾性散乱になるのであまり区別して考える必要はないのかな。 しかし弾性と干渉性の有無によって4種類の散乱があることは覚えておいた方がよさそう。 もう少し詳しく書いてあるテキストがみつかったらアップデートするかも。
何はともあれX線回折装置やX線小角散乱装置が最もよく使われる散乱装置であろう。

光電効果を介したX線と物体の相互作用

これまではX線が電子によって散乱される現象を見て来たわけだが、X線は電子とより直接的な相互作用もする。 すなわちX線が電子に出会って電子を核外にすっ飛ばしたり、その結果として外殻の電子を内殻の電子軌道上に移動させたりするのだ。
核外に飛ばされた電子のエネルギーを補足することで元素組成や化学結合を見るのがXPSと呼ばれる装置である。 さて飛ばされる内殻電子があれば空孔ができる、そこに外殻から電子が落ちてくると余剰のエネルギーが蛍光X線として放出される(これは励起源が電子線だったら特性X線、EDX)。 蛍光X線から元素同定を行うのがXRFと呼ばれる装置である。
最後にオージェ電子というものがある。 これはX線なり電子の殻移動なりによって得られた余剰のエネルギーが外殻の電子の放出という形で排出される。 AESは電子線で励起されたオージェ電子のエネルギーを捕捉する元素分析装置である。 X線と物体の反応でもオージェ電子は出るが、AES装置自体は電子線由来なのでここで紹介するのは少しトピック違いかもしれないが。

これらは全て元素分析装置であるが、試料の素材・目的の元素分析サイズ・深さなどで使い分けていくことになる。
個別の分析手法や原理については、機会があればまた別の投稿でまとめることにする。

D

pythonのlmfitを使ったカーブフィッティング

この投稿ではスペクトルなどのデータのカーブフィッティングを、pythonのlmfitというパッケージで行う方法について簡単に書きたい。 ついでなので復習も兼ねて、カーブフィッティングのバックグラウンドについても書いて見た。 lmfitについての詳細は公式ホームページが詳しいのでそちらもご覧いただきたい。

カーブフィッテイングのバックグラウンド

良い機会なのでカーブフィッティングのバックグラウンドについても少しまとめて見ることにした。 数式を使わずに書くので概略になる。 詳しい内容を知りたい人はウェブなり成書を当たって欲しい。 間違った内容・表現を見つけた方がいらっしゃったら、是非コメントでご教授いただきたい。 またlmfitのスクリプトのサンプルを見に来たという方は、投稿下部までジャンプしていただけたら。

さてカーブフィッティングのアイディアはとてもシンプルだ。 あるデータのプロットを適当な曲線で近似するだけである。 しかしその適当な曲線をどう得るかというと、そんなに簡単でもない。
曲線は関数や関数の和として考えることができる。 しかしどう関数を選択するかは自由なので、関数の取り方は無限に存在する。 基本的にはスペクトルなどデータの由来や、カーブの形からシンプルな関数を想定してフィットしていくことになるが、良くフィットしたからといって選んだ関数が正しいとは限らない。
想定する関数が決まったら、その関数を使って何かしらのデータをフィットするわけだ。 関数の種類はすでに想定済みなので、そのパラメータを決めていくことになる。

そのためによく使われるのが最小二乗法だ。 最小二乗法は各データポイントでの関数と実データの誤差の二乗を計算し、その総和が最小になるように関数のパラメータを決める方法だ。
曲線が単純な一つの多項式で表せる場合など関数がパラメータに対して線型結合である場合(関数が線形関数である必要はない)、通常の最小二乗法で正規方程式を解くことでパラメータが得られる。
一方でパラメータが二乗だったり積で表されるような線型結合でない場合は、非線形最小二乗法を使うことになる。 この計算は反復解法と呼ばれるものであり、私はLevenberg-Marquardt法を適用している。 一番よく使われている手法じゃないだろうか。
こうして得られる非線形最小二乗法の解は一つに定まらないので、もっともらしい結果を得るには初期パラメータの設定も重要になる。 スペクトルなどのピークをフィットする場合、ほとんどの場合で非線形最小二乗法を用いてフィットしていくことになる。

カーブフィッティングのためのpythonプログラミング

pythonで非線形最小二乗法のプログラムを書きたい場合だが、scipyに関数が存在している。 Scipyは最も有名というか一般的なpythonの科学用のライブラリである。 Scipyのoptimizeという関数の中に、leastsqとcurve_fitという関数が用意されている。 これらの関数を利用すれば、pythonとしては割と高速のカーブフィットができるかと思う。
例えば無機結晶の粉末回折パターンの解析がしたいというならばこれで十分良いかと思う。 若干関数を定義したりするのがめんどくさかったりもするが大した手間ではない。 まあ粉末解析は各種優秀なソフトが大量にあるので、自分でスクリプトを書く必要なんてのは全くないのだが。

さてなんでlmfitを使うのかという話だが、低結晶性の有機結晶を扱う上でいくつかのlmfitの機能が必要だったのだ。 一番大きな理由はフィッティングパラメータに制限をかけたかったこと。 高結晶性の素材を使ってる人たちに言わせれば、パラメータに制限をかけなきゃいけないなんてのは何かが間違っている証拠てことだそうだ。 しかし低結晶性の素材からそれなりにリーズナブルな値を得るというのも、現実問題として結構需要のあるプロセスなのである。

lmfitを使ったスクリプトの書き方

さてここからは一例を。 まずはlmfitのインストールをpipから。 ちなみに私の環境はanacondaのpython3(anaconda4.4.0 python3.6.1)。

pip install lmfit

実際のコードではまずlmfitのModelを呼び出しておく。 他の必要な関数も適時インポートするがここでは省略。

from lmfit import Model

私の場合はメイン関数の中でデータの読み込みと、データのフィット関数の呼び出し、フィッティング結果を描画する関数の呼び出しをする。 そしてデータのフィット関数と描画の関数を定義するが、ここら辺は好みで。 データは何かしら2カラムで、x軸に対して強度を取ったようなものを読み込むことが多いかな。

plot = np.loadtxt(argvs[1])
comps, result, int, cent = Fitex(plot)
namefig = argvs[1] +".png"
plot_fitted(plot,namefig,comps,result)

続いてフィッティングに使う関数の定義。 この例では面積計算のガウシアンとコンスタントを定義。

def gaussian(x, amp, cen, hf):
 return amp*(2/hf)*np.sqrt((np.log(2)/np.pi))*np.exp((-4*np.log(2))*((cen-x)/hf)**2)
def consta(x,con):
 return con

フィッティング操作を行う関数は以下のような感じ。

def Fitex(arr):

#x軸とy軸のカラムの指定。 もちろん自分のデータ次第。

y = arr[:,1]
x = arr[:,0]

#個別のフィッティング関数の設定。 ここではガウシアンとコンスタント。 私はフィッティング関数は自分で定義しているけど、lmfitはプリインストールモデルが結構あるはず。 prefixは後でパラメータ設定する用の名前付け。

gauss1 = Model(gaussian,prefix='g1_')
Const1 = Model(consta,prefix='c1_')

#フィットする関数群を決める。 ガウシアンとコンスタントの和。

mod = gauss1 +Const1

#フィッティングに使うパラメータを定義

param = gauss1.make_params()
param.update(Const1.make_params())

#フィッティングパラメータの初期値や制限などの設定。 ここを結構自由に設定できるのがlmfitの良いところ。 例えば、ここではConst1関数は0から1300の範囲での最小値を拾って初期値とし、その値はフィッティングの間不変に設定されている(pick_minは自己定義関数)。 gauss1関数はフィッティングに使われるが、min,maxで最大値・最小値が指定されている。 あとはexprを使って式で値を決定することもできる。 例えばparam[‘c2_con’].set(expr=’c1_con*3′)といった具合。

param['c1_con'].set(pick_min(y[0:1300]),vary=False)
param['g1_amp'].set(100000, min=0, max=5000000)
param['g1_cen'].set(180,min=170, max=190)
param['g1_hf'].set(200,min=1, max=3000)

#フィッティングの実行。 結果はresultに収納。

result = mod.fit(y, param, x=x)

#あとは適当にフィッテイング結果の出力

print(result.fit_report())
print(result.params)

#フィッティングの結果の値を他の関数から呼び出したりして使いたい時は、best_values.getで取得しておく。

comps = result.eval_components(x=x)
int = result.best_values.get('g1_amp')
cent = result.best_values.get('g1_cen')

#最後に使いたい値をリターンする。

return comps,result, int, cent

以上lmfitを使ったカーブフィッティングの例でした。 後はresult.best_fitや出力のcomps[‘g1_’]+comps[‘c1_’]などを適当なx軸に対してプロットしてあげれば絵も描ける。
最後にlmfitの公式ホームページのアドレスと、使用した際の引用先を記しておく。
[1]https://lmfit.github.io/lmfit-py/
[2]http://dx.doi.org/10.5281/zenodo.11813

関連記事

pythonのまとめ

D
pythonでraw形式の画像を読み込んで処理する方法

pythonは画像処理のパッケージが結構あるので、ちょっと画像処理をしてみようなんて始めるにも良い言語だったりする。
とはいえ研究者が2次元データの処理を自分でする機会というのはそんなにはないだろう。 手元に来る頃には1Dプロファイルなどの扱いやすい形に変換されていることが多いからだ。
しかし時たまそんな変換が納得できるものではなかったり、もしくはニッチすぎる分野にいるせいで十分なソフトウエアに恵まれない場合もある。
今回はRAW形式のデータを読み込んで、処理して書き出す方法についてまとめておきたい。

私が今使っているのはanacondaのpython3(anaconda4.4.0 python3.6.1)であるが、前のバージョンでも問題ないはずだ。 python2の場合はちょろちょろと変える必要があるかもしれないが。
さて画像処理するのには、まずは画像を読み込む必要がある。RAW形式の画像を読み込めるパッケージは色々ある。
私が最初二次元X線データの画像処理を試みたときも、色々とソフトを試した記憶がある。
ちなみにデジカメの写真なんかを読み込みたい場合は、専用のライブラリやwrapperがpythonには用意されている。

内部リンク: pythonでデジカメのraw画像を一括読み込みして別形式で保存する

しかしここで私が使うことにしたのはpillowという画像処理ライブラリ。これを選んだ理由は、様々な形式のrawデータを読み込んでくれたからであった。
私が具体的に使いたかったのは16ビットのunsignedのpixcelデータだったのだが、これを読み込んでくれたのがこのpillowであった。pillowはpipでインストールすることができる。

pip install pillow

プログラムではまずこのpillowでの画像読み込みをするのにImageを呼び出しておく。

from PIL import Image

まずはピクセルデータをバイナリモードでファイルに読み込んでrawdataに格納。ヘッダーがある場合はseekを使ってピクセルデータの場所までスキップしておく(file.seek(number))。

2022年6月23日追記:

私の使ってた画像データでは確かヘッダーサイズは画像のピクセルサイズに依存してたはずで、3000x3000ピクセルの画像ファイルではnumber=6000、4000x4000の画像ファイルではnumber=8000てな感じでうまく読み込めていたかと思います。ファイル次第な気はしますが……間違っていると画像がとてもおかしくなるので、意味のある画像が出てきたらnumberがあってるはずです。

追記終わり。

file = open(filename, 'rb')
rawdata = file.seek(number)
rawdata = file.read()
file.close()

読み込んだバイナリをpillowのImage.frombytesを使ってイメージ形式に変換する。
オプションは左から、mode、size、filename、data、decoder_name、args。 modeは公式を読むと32ビット?と思いつつもFで良い。
sizeは私の場合ピクセルサイズで(2000,2000)など。 dataはこの例だとrawdata。

最後の二つが実質重要で、decoderでrawを指定して、argsで実際のファイルフォーマットを指定する。 私の場合は16ビットのbig endianだったので16B。
ここの指定がおかしくて、変なデータになることがよくある。 正しくプロセスするには、自分の使っている画像データをよく知っておく必要がある。 ちなみにどのデータタイプにどのargsを使えば良いかは公式ページに詳しい。

img = Image.frombytes('F', Imagesize, rawdata,"raw", 'F;16B')

ここまできたらimgはイメージデータになっているので、適当な画像形式で出力してあげれば正しく処理されているかが確認できる。

img.save("test.tif")

私はnumpyを使ってデータ処理することが多いのでさらにnumpyのarrayに突っ込んでおく。

npimg = np.array(img)

ここまできたらnumpyの(ピクセル、ピクセル)のデータになっているはずなので、あとは好きな様に補正を加えるなり図表を作ることができる。

関連記事

pythonのまとめ

D

海外でのポスドクの始め方 〜応募から面接まで

ようやく100投稿目ということで何を書こうかと少しなやんだ。 色々考えてみたのだが、このブログを始めるきっかけともなった海外ポスドクの始め方について書いてみることにした。

海外でポスドクをすることについての雑感

さて始め方とはいったものの、将来的に日本で就職を考えている方々は始めない方が良いのかもしれない。 就職をしっかり決めてからサバティカルなり、海外学振なりで経験を積みに行くのが王道なのだろう。 または共同プロジェクトでもやってるとこなら、日本所属のまま海外出られるし。 アメリカの国立研究所にいた時は、そのようにアメリカで働いているポスドクが結構いた。
海外雇いになると日本の学会にいくのに予算を出してもらえるかわからないし、日本での就職のためのコネクションをキープするのも結構大変だ。 某東大の先生に日本での就職についてご教示いただく機会があったのだが、博士の就職活動はまずはコネと若さ。 業績やスキルが重要でないわけではないが。 海外に下手に出るとより大切な若さとコネを失う可能性がある。 ちなみに海外で就職する場合でもコネは重要。 若さについては年齢差別になるから海外の人はまず言わないけど。
しかしさまざまな都合で海外でポスドクをするのがベストの選択という方もいるだろう。 海外でそのままポジションを取りたい人とか。 または私のように国内で就職先が全く見つからなかったから、海外逃亡するという方もいるのかいないのか。

どうやって海外ポスドクへの応募するか

さて海外でポスドクを始めたいときにどうするかである。 まずは公募に普通に応募するパターン。 有名どころだと、サイエンス・ネイチャー・ACSなどのウェブページにたくさん公募が出ている。 最近だと色々とポータルがあるので、求人情報には困らないだろう。 あとはとても行きたい大学や施設がある場合は、そこのホームページの求人をちょこちょこ直接チェックする。 結構出せそうなポスドクがあったりするものだ。
自分のスキルやテーマにあっている求人を見つけたら、CVなどの要求書類を添付して応募することになる。 ポスドクだったら大して書類はない。 書類選考を抜けると電話面接などの連絡が来る。 ここまできたら数人の最終候補での競争になっている。 ここまで来ると結構チャンスはあるものだ。 たとえ一番ではなくても、他の候補者が別のポストを優先するかもしれないので。
ちなみにどこでもそうだと思うが、知り合いの本命候補がいてまず無理って公募は結構ある。 妙にスペシフィックな条件が記述されていたら、そうなのかもしれないなと思いつつcvだけ送っておくとよい。 いずれにしろこのパターンでは数を撃たなければあたらない。 二ヶ所以上お話が同時に来たら条件のよいところを選べばよいのだ。
しかしニッチな研究分野では、そうそう都合の良い公募が見つかるものでもない。 そんな時はやっぱりコネだ。 博士論文を書くのにも、今の時代一人や二人海外からの共同研究者がいるものだろう。 そういった人たちにちょろっとポスドクの予算がないかきいてみるとよい。 結構予算持ってたりするし、彼らの友達に予算を持っている人がいるか聞いてくれたりするかもしれない。 先に話しが通っていると、大分採用される確率が高くなる。 いずれにしろ公募にはなるのだが、条件が大分絞られていて競争率が低くなっていたりする。 こちらのパターンでも落ちるときは落ちるようだが、成功率はかなり良いはずだ。 ちなみにこちらのパターンでも、他にもっと良い職があったらそっちを取るってことは結構あるようだ。 アメリカのポスドクに応募した時は、受かったら本当に来るのかどうかってことを面接でしっかり確認された。

以下は実際にアメリカとフィンランドのぽすどくに応募したときの体験である。

アメリカのポスドク・応募と面接

博士号を取得してしばらく就職先が見つからず、大学で無給の研究員をやっていたときだった。 元ボスから共同研究者の一人がどでかい予算を当てたからポスドクを一人とれるかもしれないとの連絡。 すぐさま雇ってくれるなら頑張って働きますと伝える。 しばらく待っていると、面接試験がしたいとの連絡があった。 電話面接でも良いけど、来てくれたら飛行機と食事ホテル費用はだすとのことであった。 そこで当時電話での英語にまったく自信のなかった私は、アメリカまで面接しにいくことにしたのだった。

さてこの時の面接試験は丸一日を使ったなかなか盛大なものであった。 日程的には夜到着。 次の日が一日試験。 翌々日の早朝には帰りの飛行機に向けて空港へ向かうという二泊四日の強行軍。 なのでコンディションはなかなかに最悪だった。 とはいえ共同研究者は相変わらずとてもよい人で、最初にお話して英語をならしつつリラックス。 それからそのラボで一緒に働くことになる研究者たちと一人30分ずつくらいの面接ラッシュ。 お昼ご飯を食べたら小さなセミナーで30分程度の発表。 その後も面接がいくつかと、施設見学などをびっちりと。 すべてが終わったのは6時くらいだったかな。 とても密度の濃い一日であった。 面接が終わった後は精魂尽き果てており、翌日のフライトに備えてホテルで寝るのみであった。

日本に戻った後はサンキューレターを一応書いたけど、元々知り合いの所にいく場合はそこまで重要ではないのかな。 まあ一応礼儀として。 数週間待った後に無事採用の連絡が来たのだった。
ちなみに後日談だが共同研究者はよっぽどでなければ私をとる予定だったそう。 同僚にはほぼ決まってたんだから、旅費の無駄だったんじゃないかと冗談混じりに言われてしまった。 しかし強行軍の面接と慣れない電話面接のどちらがよかったかは今でもよくわからない。

フィンランドのポスドク・応募と面接

こちらはフランスのボスの所にフィンランドの知り合いから、ちょうど私のような研究をしてるぽすどくが欲しいとのメールが来たのだった。 とても良いプロジェクトだったので、ボスに転送してもらった後にすぐさま応募。 書類はCVと論文3報だったかな。 しばらく待つと、スカイプで面接をしましょうとの連絡が来たのであった。
面接当日はネットワーク障害か何かでなぜかスカイプがつながらず。 しょうがないので、携帯電話で話すことにしたのだった。 こちらは予算は大きいけれど、規模は小さなプロジェクトだったので今のボスとだけ面接で良かったのだった。 なので電話でちょろっと話すというので問題はなかった。

面接で話したことと言えばまずはプロジェクトの内容について。 内容は応募したときにもちろん把握はしていたのだが、どの程度すでにプロジェクトが進んでいるのかや、就職先で使える実験装置などについて具体的に話した。 後このポジションは結構旅が多くなりそうなので、どの程度旅に出られるかなどの確認。
また契約期間や契約条件などについても、しっかりと確認しておいた方が良い。 結構適当に喋っていると後ほど細かいところが違っていたってこともあったりする。 アメリカの時は3年までポスドク更新できると面接の時に話した記憶があったのだが、ボスは2年までだと思っていたのだ。 結局問題なく更新はできたのだが、最初にしっかりと確認しておく方が後々問題がなくて良い。
この面接時には私の先行きがきまっていなかったこともあり、できるだけ一年は続けて欲しいと向こうから言われたのだった。 私はこの時テニュアトラックのポジションも出していたので、それを伝えた上でできるだけ1年やれるように努力はしますと伝えた。 結局他は全敗だったので何の問題もなかったのだけど。
ちょっと採用先で色々事情があったようで、お返事は数ヶ月待つことにはなったのだけど、最終的には採用の連絡が来たのであった。

関連記事

1. 国による労働環境の違い 〜四カ国働いてみた感想

2. 国による生活環境の違いについて 〜4カ国+1に住んでみての感想

3. 海外就職手続きのまとめ

D

国による労働環境の違い 〜四カ国働いてみた感想

日本も含めればアメリカ、フランス、フィンランドと四カ国で働いてきた。 ポスドクをこれ以上することもないだろうし、この機会に各国の労働環境について考えて見ることにした。 この投稿では特に労働時間や休暇などに絞って書いていきたい。 研究への取り組みなどは、チャンスがあれば後ほど別の投稿にまとめる。
ポスドクはそもそも結構特殊な職業であるし、個々の研究所大学などによる労働環境の違いももちろんある。 それも踏まえた上で自分のこれまでの就労の中で感じた違いをまとめておこうと思う。

日本の労働環境

給料をもらっていた博士過程と無給の研究員をちょっとという経験。 働いていたといっていいかは微妙なところではある。 と書いていてふと思ったけど、PhD studentレベルが無給で勝手にやってくる日本ってやっぱりすごいな。 それが日本の科学を押し上げてもいるし、端々にガタが来る原因にもなってしまうのかしら。
日本の大学は学生の滞在時間は自由だった。 教授も結構遅くまで働いていたりしたし、好きにやっていた感じ。 長く働いてても文句はいわれないが、短いとボスに注意くらいはされると思う。
しかしタイムマネージメントのシステムは一切なかった。 裁量労働制というものだ。 自分で適当に切り上げるのがうまい人にはいいかもしれない。 同僚の中国人ポスドクなんかはこのシステムの中でうまいことやっていた。 一方私はこのマネージメントが少しずつうまくいかなくなって失敗した。
とはいえ最終的にPhDが取れたのだから、周りのサポートしてくださった方々には感謝。

アメリカの労働環境

ポスドクひとつ目。
アメリカというか国立研究所だからかな、仕事時間は8−5くらいでとてもかっちりしてた。 装置のエンジニアとかは6−3とかだったが。 休憩時間を抜いて1日8時間縛り。 必要があれば時間外に実験することはもちろんあったが、働いた時間分は週内くらいで振替の時間休をとっていた。
働きすぎているとそれとなく注意が来る。 はたらいてないほうは注意のあとで首になると聞いたが、近場にそんな人がいなかったので実際のところはわからない。 ここもタイムカードは自分でオンライン入力するだけだったが、周りが誰も働いてなければ自然と帰るものだ。 あと時間外の単独労働は禁止だった。

私のボスは結構お偉い人だったが、彼も8−5時できっちりラボでの仕事は終えていた。 忙しい時期には家に帰ってから論文の更正をしてくれたりしていたので、部下のための家での残業は少ししてくれていたけど。 基本的にアメリカは時間内でかっちり仕事を終わらせることに美徳がある印象(アジア系のボスとかだとそうでもなかったりするが)。

有給休暇は年14日だったかな。 有給休暇に加えて病気休暇は保証されていた。 フランスなどに比べるとだいぶ少ないが、しっかり使い切ることができるし翌年度への繰越もできる。 あと確か常勤になると少しは増えたはず。

かっちりしている上にそれとなく過剰労働への予防線を張っていた。 仕事の効率や働きやすさのバランスがとても良い国だと思う。

フランスの労働環境

ヨーロッパに移ってポスドク二つ目。
フランスも研究所ではあったけど大学内の機関。 学生がいっぱい。 フランスはアメリカに比べると良くも悪くもいい加減。
朝それなりにゆっくり来る人もいれば、夜型の人も。 ここだけみると日本と同じにも見えるが、そんなことはない。 職場に来てたって、朝のコーヒー、長いランチ、食後のコーヒーなんてしてるのだから別にたいして働いているわけではない。 がしかし最後には仕事をキッチリ仕上げてくるのだからよくわからないところだ。 集中力の使い方がうまいのかな。  有給は年一ヶ月とチョイ。 有給使いきらないとボスに怒られたりする。
私の性格にはフランスという国の働きかたは馴染まなかったが、人によっては離れがたい魅力があるそう。 フランスも自分でマネージメントができる人向けかな。 働きすぎとるいう意味ではなく、仕事の成果をある程度出すためにという意味で。 私生活も仕事も楽しさが一番というタイプの人にはあっているのかな。

フィンランドの労働環境

ヨーロッパ二カ国目。 大学のポスドク。
ヨーロッパだが雰囲気はフランスよりアメリカな印象を受けている。 うちの大学の場合一般職は一日7.35時間と決まっている。 研究職は一年1624時間と決まっており、それをどう使うかは個人の自由だ。 1624時間は1日8時間で203日。 週末以外が260日で15日の祝日があるので、やはり1ヶ月ちょいの有給休暇ということになる。
アメリカと同じく時間外、週末の単独労働は禁止。 もちろん学位論文の提出が近いなどで遅くまでいる学生もいるが、基本的にはみんな定時で帰っている印象。
フィンランドのシステムもとても好き。 年に一定時間しか働けないので、 過剰労働はまあしない。 かといって忙しい時期にはしっかりと時間を使える。 またこの時間しか働けないとなると、いかに効率的に時間を使うかを考えないといけない。 だらだらと働くよりはよっぽど良い。 良いところどりというほどではないが、アメリカとフランスの間に位置している印象。 バランスが良い。

まとめ

という感じの四カ国就労体験談でした。 今のところ定職につくならフィンランド、次点でアメリカという感じかな。 とはいえもう一カ国くらい試してみたいと思っている私は、あまり研究職には向いていないのだろう。 普通海外で就職するなんて人はやりたいことで場所を決めるものだろうけど、ちょっと働く労働環境を変えてみたいなと思っている人の参考になれば幸いだ。

関連記事

1. 海外就職手続きのまとめ

2. 国による生活環境の違いについて 〜4カ国+1に住んでみての感想

D

軽くて強いカーボンファイバーを身近な素材へ

カーボンファイバーは高分子前駆体かグラフェンなどのカーボン材料から作られた、92%以上の炭素含有率を持つファイバー状もの。[1]

というのが最近の定義だそうだ。 非常に高強度の割に密度が低く、とても軽いという性質を持っている。 繊維方向の引っ張り強度はべらぼうに強く、チャンピオンデータだとほぼ全ての材料を見回しても5本の指に入る。
変形耐性というか弾性もとても高いのだが、素材や製法によって結構コントロールができたりもする。 酸化されやすのが難点だが、それ以外には化学的にとても安定な繊維と言える。

上記のように物理的にも化学的にも高強度と言えるカーボンファイバーである。 カーボンファイバーの原料はポリアクリロニトリル(PAN)がメインだ。 実はこのポリアクリロニトリルからのカーボンファイバーを開発したのは日本人だったりする。 そのこともあってか、日系会社のカーボンファイバー事業はかなり強いようだ。 もう一つの現実的な素材は、ピッチと呼ばれる原油残渣である。 今wikipediaを見たらこちらも実は日本人開発であり、やはり日系企業が頑張っているようだ[2]。 カーボンファイバーが実際に何使われているかというと、航空機素材、スペースシャトル素材や風力発電機の素材などである。 最近(ちょっと前か・・)だとボーイング787の機体の多くのカーボン繊維を混ぜて軽量化に成功したというニュースは耳に新しい。

作り方は原料から作った繊維を炭化するのだが、前処理・炭化・グラファイト化などの工程がありそんなに単純ではない。 また素材によっても製法はだいぶ異なっている。 炭化の詳細はこの投稿のトピックではないので省略するが、それぞれの素材から高性能ファイバーを作るのに多大な努力がなされてきたのだ。

さてPAN系にしてもピッチ系にしてもだが前述のように材料機能はとても高く全く問題がない。 さらなる高機能性を求めて研究を行っている研究者・企業がもちろんいるんだろうけど。
一つ問題をあげるとするならば価格だろう。 ちょっと最新のデータかはわからないが、PAN系のコストは約2000円/kgほど。 ピッチ系はさらに高額。 用途が用途なので高額なのは大した問題にはなっていないのだろうが、ちょっと裾野を広げていこうと思うとこのコストがネックになる。 価格さえ落ち着いてくれば、車はもちろんのことレジャー・スポーツ用品などにもガスガスと使うことができるだろう。

また基本的に石油原料なので、地球温暖化・カーボンニュートラル・持続性的なことを言い出した場合には問題がある・・・なんていうのは生物材料研究者の枕詞なのだが、実際に持続的に育成・リサイクルができる生物材料からカーボンファイバーが作れるならばそれは良いことではないだろうか。

ちなみに世界で最初のカーボン繊維は実は植物由来。 Pan系が出てくる少し前、アメリカのナショナルカーボン社がレーヨンと呼ばれる再生セルロース繊維からカーボンファイバーの作製に成功している。 しかしセルロースから作ったカーボンファイバーはイマイチ性能がよろしくない。 加えて酸素含有量が高いこともあり、カーボンファイバーの収率はかなり低いものであった。

性能が上がらないところには、素材的な限界があると言える。 しかし航空機に使うわけでもないのなら、低グレードのカーボンファイバーでもそれはそれで需要があるものなのだ。 この低グレードのカーボンファイバーをいかに生物材料から安く作るかというところに、研究ひいてはビジネスチャンスがあるのではないだろうか。


D


参考資料

[1] Carbon Fibers: Precursor Systems, Processing, Structure, and Properties
Erik Frank et. al. Angew. Chem. Int. Ed. 2014, 53, 5262 – 5298

[2] 「炭素繊維」『フリー百科事典 ウィキペディア日本語版』(http://ja.wikipedia.org)。2017年3月1日 (水) 02:40更新版


研究補完ツールとしてのプログラミング

最近だとどの分野の研究をしていても、プログラミングは必須とまでは言わないが、プログラミングスキルがあると便利以上の利益がある。 就職の要件なんかにも結構入っていたりするし。 しかし、プログラミングを専門とするわけではないのなら、必要以上にプログラミングに時間を取られるのは本末転倒でもある。 ベストなのは高速言語で必要なプログラミングをしてくれる同僚がいる状況ことだろう。 私の学生の頃のボスの一人はC++をガリガリ書くタイプだったのだが、彼にスクリプトを書いてもらうと仕事が三倍速で進んだ。 しかし、現実問題そんなスキルを持った同僚が、自分の必要なタイミングでプログラムを書いてくれるなんてことはないのだ。
学生生活を終えポスドクを始める時に、周りが基本スキルとして求めてくることは、博士課程での専門知識やスキルだろう。 私の場合は高結晶性材料の結晶構造をやっていたので、まずそれが第一であった。 幸いにして、直属のボスとその分野で二報論文をさっと書くことができ、スタートはとても順調であったのだ。 さて、ポスドクでは少しずつ違うテーマにも手を出して行くことが多いだろう。 私の場合その一つがボスの同僚の一人であった中ボスと始めた、より低結晶性材料の解析だったのだ。 結論から言うと、これがひどいことになった。 今現在でも一報すらもパブリッシュされていない。 この理由は実際他にもいろいろあるのだが、それらの理由は振り返って改善できるものでもないしここでは置いておく。 今回の投稿ではプログラミングに一つの原因を求めてみたい。 さて私の博士論文はプログラミング抜きにしては語れないが、それは元ボスの恩恵が大きかった。 しかしそんなことは中ボスには関係ないので、私が低結晶の素材を扱い出したとき、私に求められた一つはデータ解析用のプログラミングだった。 しかし伊達に元ボスにしごかれていたわけじゃないと、C言語のプログラムを幾つか書いてみたのだ。 結論から言えば書けたわけだが、やはりそこは付け焼き刃。 まず書きたいプログラムの初稿を書くのに時間がかかる、そしてコンパイルにも時間がかかる、さらにバグ探しにも時間がかかる。 これだけ時間がかかっていては、プログラム自体がいくら早く計算をしてくれても意味がない。 さらにそうして書いたプログラムも、一度解析に使われたらおしまいで、再利用されたわけでもなかった。 ようするにコストパフォーマンスが悪すぎたのだ。 私のこの時の失敗は、元ボスのプログラムを使ったり書き換えたりに慣れすぎて、一からのプログラムでもそれなりの時間で書けると誤認したことだ。
さて、その中ボスとの仕事はダラダラと成果が上がらなかったわけだが、他のグループとの共同研究はそれなりに結果が出ている。 これもまた他の要因も大きいのだが、私個人として変えたこともある。 C言語からPythonに乗り換えたのだ。 Pythonは高級言語なので、プログラムの計算速度はとにかく遅い。 早くするテクニックはあるが、それはようするにどれだけC言語下で動かすことができるかと改変することである。 とはいえ、そこにプログラムの準備時間を加味するとなると話は別だ。 そのシンプルな構造と、数多くのプリセット関数がスピーディなプログラミングを可能にする。 また使っている人が多いので、トラブルシューティングがウェブでとても簡単に見つかる。  また私の印象としては、改変しての再利用もしやすい。 そういわけで今の所Pythonは、私の研究活動のサポートツールとしてとても役立ってくれている。

もちろんケースバイケースで考えなければならない。 莫大な計算量を走らせるなら、多少時間がかかってもC言語で書く価値がある。 しかし、Pythonをベース言語として習得することは、研究活動をしていく中でコストパフォーマンスがとても良いと思う。 最近少し忙しくなってきたので、実際にどの程度書いていけるかはわからないが、このブログの科学カテゴリーでは少しづづpythonのTIPSなどを書いていきたいと思っている。

関連記事

pythonのまとめ

D